- ホーム
- Web・SEO・ネットワーク
- テキスト分析ツール
テキスト
文字数・
最終更新日:入力データはブラウザ内で処理
文章の文字数・バイト数・行数・読書時間・文字種の内訳と、よく出てくる語句を集計します。入力欄やデータベースの上限の確認や、原稿の分量の確認に使えます。入力したテキストはブラウザ内だけで処理します。
テキストを入力すると分析結果が表示されます
テキスト分析ツールの使い方
貼り付けた
手順の
「分析する
テキスト」に 文章を 貼り付ける 入力する
たびに 「基本統計」 「文字種類別」 「文字構成比」 「キーワード 出現頻度」が 更新されます。 「サンプルを 読み込み」で、かな・ 漢字・ 英数字・ 記号が 混ざった 試しの 文章を 入れられます。 撮影した 例では、 商品説明の 下書きを 1 段落貼り付けました。 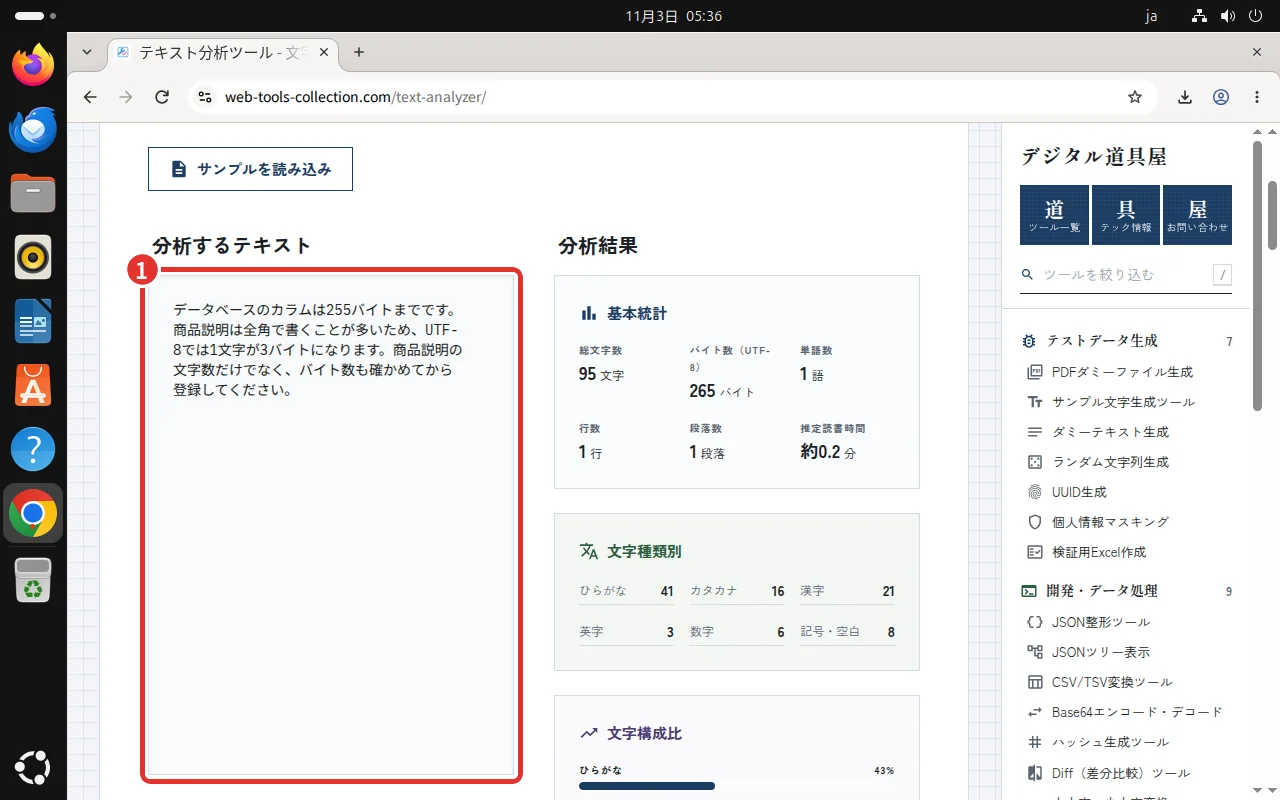
上限の
単位に 合わせて 文字数か バイト数を 見る 入力欄や
SNSの 上限が 文字数で 決まっているなら 「総文字数」を、 データベースの カラムや APIの 上限が バイト数で 決まっているなら 「バイト数 (UTF-8)」を 見ます。 「総文字数」は 空白と 改行も 1文字と して 数えます。 撮影した 例は 「95文字」 「265 バイト」でした。 英数字の 10文字が 1バイトずつ、 残りの 85文字が 3 バイトずつなので、 10+85×3=265 バイトです。 上限が 255バイトの カラムには、 文字数が 少なくても 入りません。 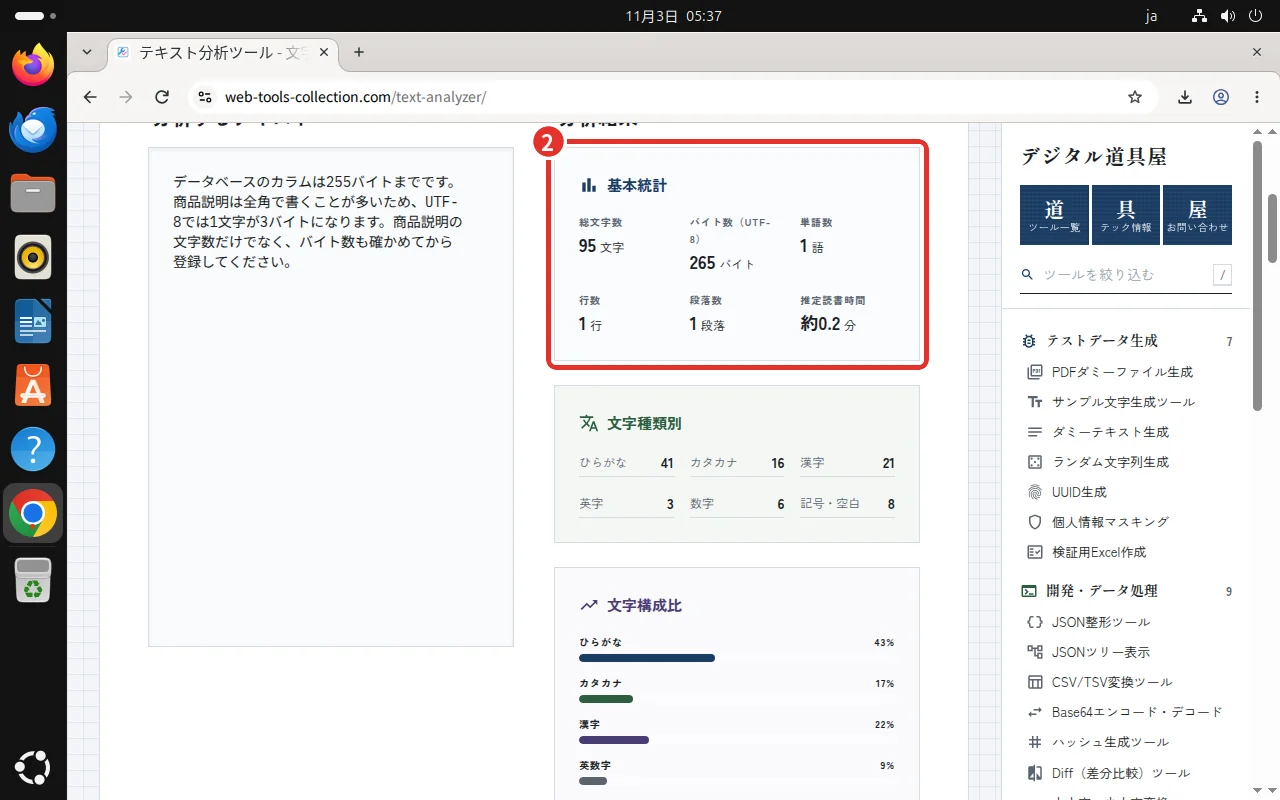
「キーワード
出現頻度」で 同じ 語の 繰り返しを 探す 英単語・連続する
漢字・連続する カタカナが、 出現回数の 多い 順に 15語まで 並びます。 同じ 語が 続いて 読みに くくなっている 箇所を 見つけ、 言い 換えや 省略を 検討します。 撮影した 例では 「バイト」が 3回 (25%)、 「商品説明」が 2回で 上位に 並びました。 「255バイト」 「3バイト」 「バイト 数」のように、 数字や 漢字が 続く 語からも カタカナの 部分が 拾われます。 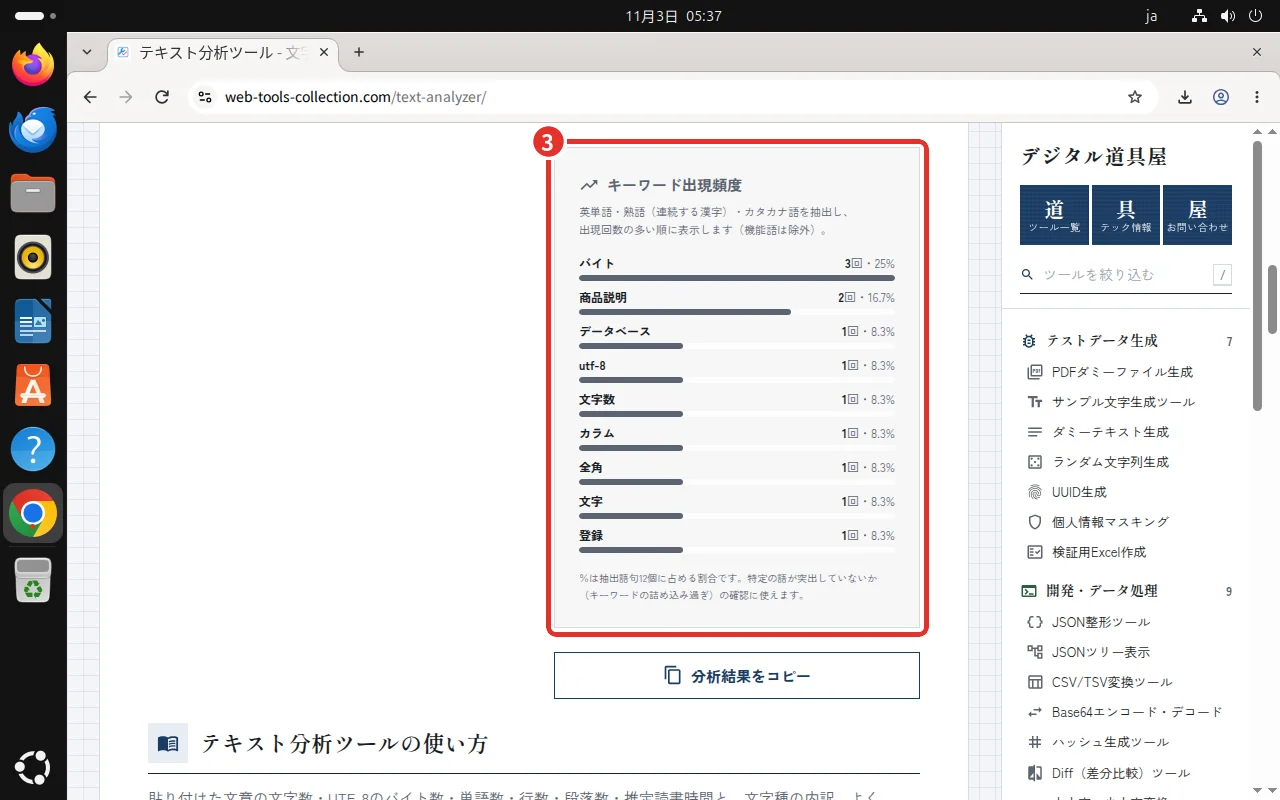
「分析結果を
コピー」で 記録する 基本統計・
文字種類別・ 文字構成比・ キーワードの 一覧を、 箇条書きの テキストと して コピーします。 原稿の 分量を 記録したり、 レビューの 依頼に 添えたりする ときに 使います。 
各数値の数え方
ほかの
| 項目 | 数え方 | 食い違いやすい点 |
|---|---|---|
| 総文字数 | JavaScriptの文字列の長さ(UTF-16のコード単位の数)。空白と改行を含む | 絵文字は1つで2以上になる |
| バイト数(UTF-8) | TextEncoderでUTF-8に変換したときのバイト数 | 英数字は1、かな・漢字の多くは3、絵文字は4バイト |
| 単語数 | 空白と改行で区切ったかたまりの数 | 空白のない日本語の一文は1語 |
| 行数 | 改行の数に1を足した数 | 末尾の改行も1行に数える |
| 段落数 | 空行(改行が2つ続く所)で区切ったかたまりの数 | 空白だけの行は区切りにならない |
| 推定読書時間 | かな・漢字を400字/分、英単語を200語/分で計算し、長いほうを0.1分単位で表示 | 日本語と英語の合計ではない |
| 文字種類別 | ひらがな・カタカナ・漢字・半角英字・半角数字を数え、残りを「記号・空白」とする | 全角英数字と「ー」「々」は記号に入る |
| キーワード出現頻度 | 英単語(2文字以上、機能語を除く)・2文字以上続く漢字・2文字以上続くカタカナを抜き出し、回数の多い15語を表示 | %は抜き出した語の延べ数に対する割合 |
形態素解析は使っていないので、日本語の語の区切りは近似です。「東京都庁」は1語、「東京の都庁」は「東京」と「都庁」の2語として数えます。どの熟語やカタカナ語を繰り返し使っているかの傾向は分かりますが、厳密な単語単位の集計が必要なときは、MeCabやSudachiのような形態素解析器を使ってください。
使用例
技術ブログ記事の文字数の確認
見出し
入力
# Next.js 14で作るモダンWebアプリケーションの実践記録

## はじめに
最近、Next.js 14のApp Routerを使って新しいプロジェクトを始めました。TypeScriptとTailwind CSSを組み合わせて、開発効率が格段に上がったので、その実践記録をまとめてみます。

## 環境構築のポイント
まず、create-next-appでプロジェクトを作成する際の設定について。

```bash
npx create-next-app@latest my-app --typescript --tailwind --eslint
```

このコマンド一つで、TypeScript、Tailwind CSS、ESLintが全て設定されます。昔は手動で設定していたので、本当に便利になりました。

## App Routerの利点
App Routerの最大の利点は、ファイルベースのルーティングとServer Componentsの組み合わせです。特に、SEO対策が格段に楽になりました。

以前はgetServerSidePropsやgetStaticPropsを使っていましたが、Server Componentsを使うことで、より直感的にサーバーサイドの処理を書けるようになりました。

## パフォーマンスの改善
Lighthouseのスコアも大幅に改善されました。特に、Core Web Vitalsの改善が顕著です。

- LCP: 1.2秒 → 0.8秒
- FID: 45ms → 12ms
- CLS: 0.15 → 0.05

これらの改善により、ユーザー体験が格段に向上しました。

## 今後の展望
Next.js 14の新機能を活用して、さらにパフォーマンスの向上を目指したいと思います。特に、Server ActionsとServer Componentsの組み合わせで、より効率的なアプリケーション開発ができると期待しています。

開発の記録を続けていきたいと思います。
SNS投稿の文字数の確認
Instagramの
入力
今日は朝から雨が降っていて、なんだか落ち着かない一日でした。でも、そんな日こそお気に入りのカフェでゆっくり過ごすのが一番だと思いませんか?今日は、最近ハマっているエチオピアのシングルオリジンを選びました。フルーティーな香りと、ほんのりとした酸味が特徴で、雨の日の憂鬱な気分を一瞬で吹き飛ばしてくれます。バリスタさんが丁寧にハンドドリップで淹れてくれて、その過程を見ているだけで癒されます。コーヒーを淹れる音、香り、そして味わい。全てが完璧なハーモニーを奏でているようでした。カフェで読んでいた本の中で、とても印象的な文章に出会いました。「人生は、小さな選択の積み重ねでできている」この言葉を読んだ瞬間、なんだか胸が温かくなりました。私たちは毎日、無数の選択をしていますよね。朝起きる時間、着る服、食べるもの、話す言葉...。明日は晴れる予報なので、久しぶりに公園でピクニックをしようかなと思っています。お弁当を作って、お気に入りの本を持って。きっと素敵な一日になるはずです。今日も一日、ありがとうございました。明日も素敵な一日になりますように ✨
よくある質問
文字数を
文字数
「キーワード
抜き出した
キーワードの
形態素解析は
日本語の
「単語数」は
日本語と
読書時間は、
文字数と
「総文字数」は
絵文字や
「総文字数」は
全角の
「英字」
コツと注意点
改行と
「総文字数」は
行数は
「行数」は
タイトルと
検索結果の
関連ツール
関連する記事
このツールの裏側にある仕様や、使いどころを書いた記事です。